Все проекты
Личные и open-source проекты

Lumen Мультитенантный RAG- и MCP-сервер на .NET, который строится поэтапно, а каждое проектное решение исследуется и фиксируется.

NET-сервис в активной разработке: загружает документы, индексирует их для векторного поиска и отдаёт поиск в виде MCP-инструментов, которые AI-агент может вызывать напрямую, — с изоляцией тенантов, доказанной тестами, а не просто предполагаемой.

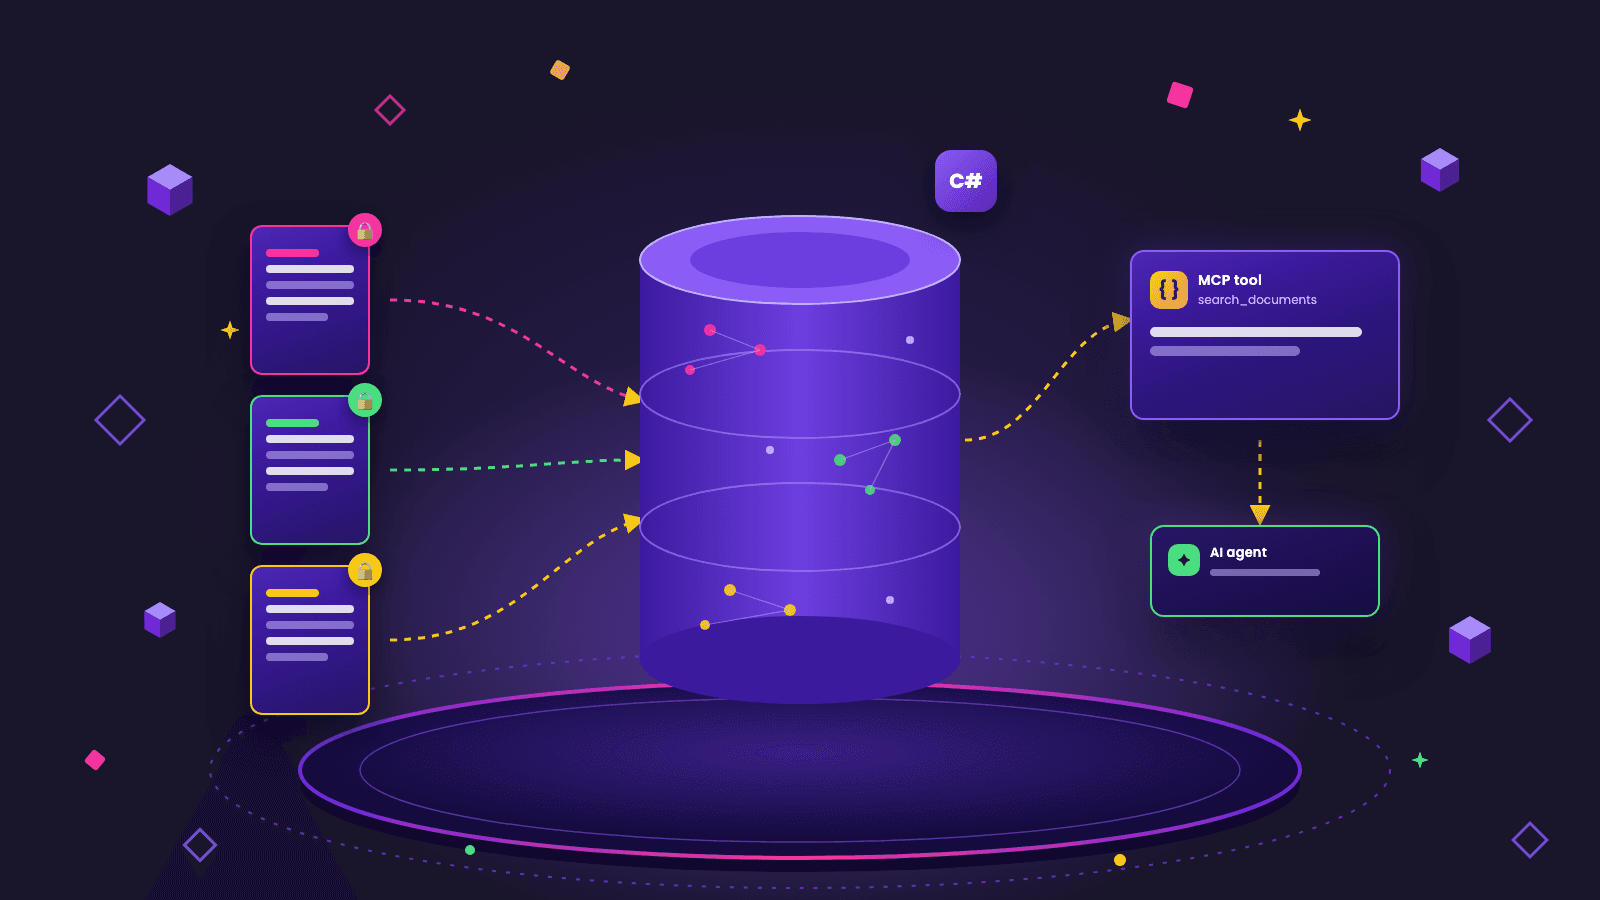
Иллюстрация: Lumen индексирует документы разных тенантов для векторного поиска и отдаёт их AI-агенту в виде MCP-инструментов

Отрасль

AI-инфраструктура / инструменты для разработчиков — RAG и MCP

Мой вклад

  • Архитектура (Onion Architecture
  • .NET)
  • Проектирование и проверка мультитенантности
  • Выбор базы данных и технологии векторного поиска
  • CQRS-бэкенд (EF Core
  • MediatR
  • PostgreSQL)
  • Стратегия тестирования (модульные + интеграционные тесты
  • доказательство изоляции тенантов)
  • Направление проекта и журнал решений
Слои Onion Architecture в Lumen — от API до домена, с проектами модульных и интеграционных тестов

О проекте

Lumen — личный проект: мультитенантный сервер Retrieval-Augmented Generation (RAG) и Model Context Protocol (MCP) на .NET. Он загружает документы, индексирует их для векторного поиска и отдаёт поиск в виде инструментов, которые AI-агент (например, Claude Code) может вызывать напрямую. Проект в активной разработке и строится поэтапно, с собственным журналом решений — чтобы решения не принимались и забывались, а оставались записанными.

Технологии: C#, ASP.NET Core, .NET, EF Core, PostgreSQL, pgvector, Azure OpenAI, Microsoft.Extensions.AI, Semantic Kernel, MediatR, AutoMapper, JWT, xUnit, Testcontainers, Docker

Задача

Хотелось сделать проект глубже, чем подключение LLM API к чат-интерфейсу, — такой, который проверяет настоящую бэкенд-инженерию на ограничении, которое легко изобразить и трудно реализовать правильно: мультитенантность, выдерживающую пристальную проверку, а не просто код, который компилируется. Нужна была и реалистично «грязная» предметная область документов для индексации вместо чистого демо-текста, и понятный практический итог — MCP-сервер, к которому AI-агент может обращаться напрямую, а не демо-скрипт.

Решение

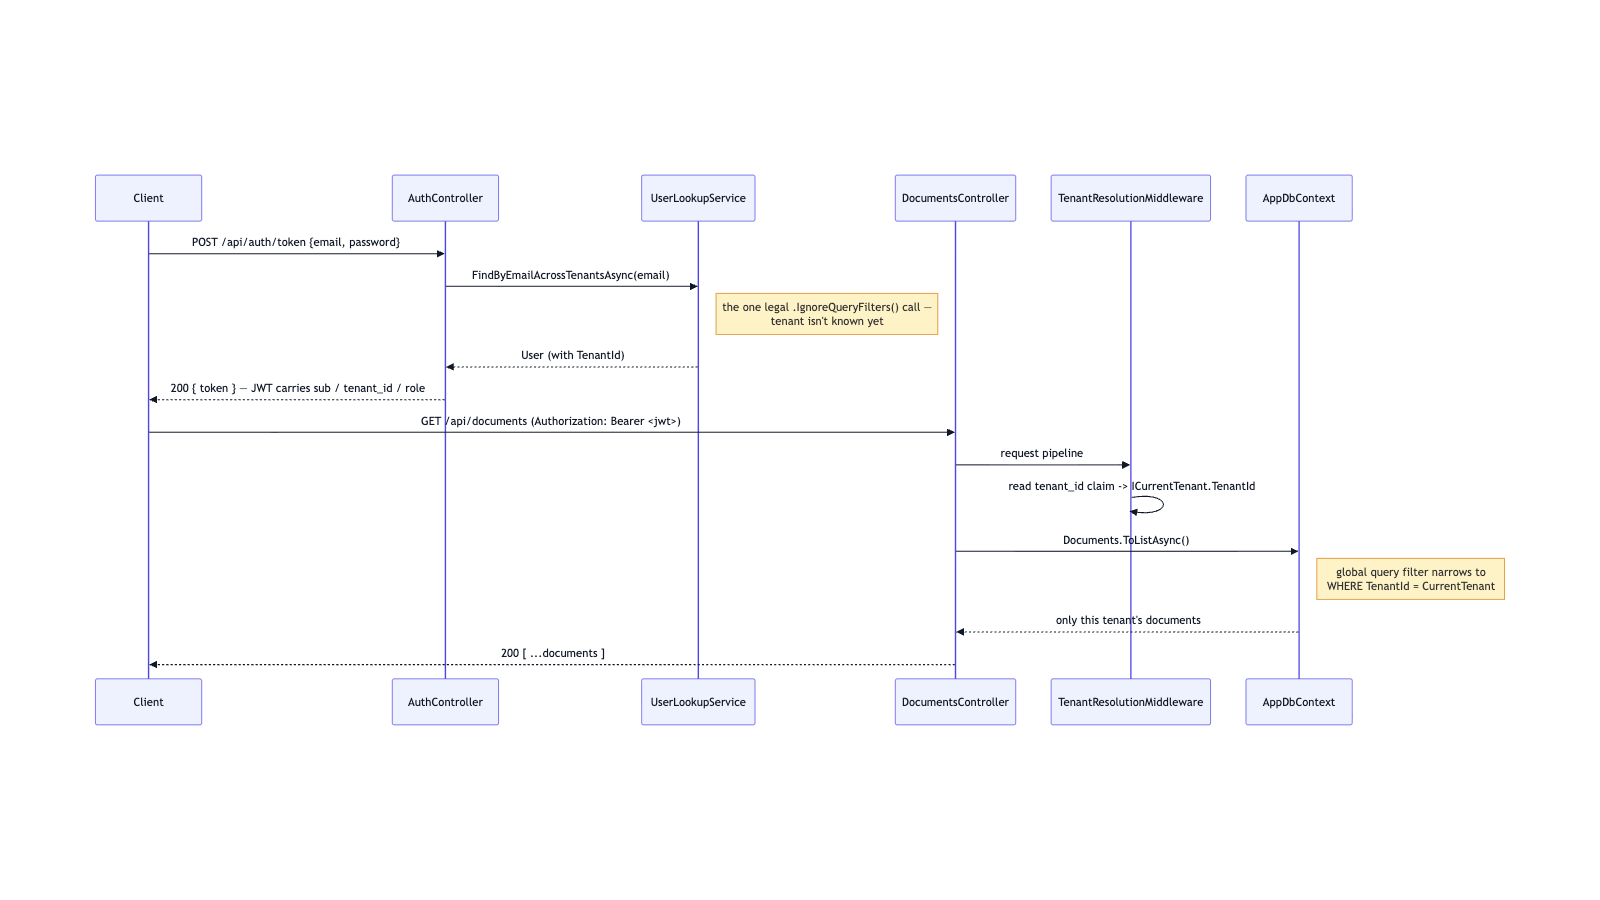
Проект строится поэтапно, а не весь сразу: каждый этап проходит собственное исследование, проектирование и реализацию, прежде чем начинается следующий. На этапе 1 заложен фундамент: .NET-решение по Onion Architecture (Domain → Application → Infrastructure → Api), собственная JWT-аутентификация и мультитенантность через global query filter в EF Core ровно с одним осознанным и задокументированным исключением — поиском пользователя при входе, который выполняется ещё до того, как известен его тенант. Каждое нетривиальное решение записывается в журнал вместе с обоснованием и, где возможно, измеренными цифрами — а не просто «выбрали X». Сама разработка идёт по spec-driven процессу с участием AI-агентов: у каждого этапа есть письменный дизайн и пошаговый план, AI-агент реализует каждую задачу, отдельный проход ревью сверяет её со спецификацией и проверяет качество кода, и ничего не идёт дальше без проверки реальной сборкой и прогоном тестов. Архитектура и решения за ней всё это время остаются под прямым контролем и не делегируются вместе с кодом.

Этапы 2 и 3 строятся на этом фундаменте: пайплайн документов, который превращает реальную отчётность SEC (HTML и PDF) в типизированные элементы — заголовки, абзацы, таблицы — и разбивает их на чанки по бюджету токенов, а затем эмбеддинги в PostgreSQL с pgvector и поиск по сходству в пределах тенанта.
Технический подход

  • Архитектура: Onion Architecture из четырёх слоёв (Domain, Application, Infrastructure, Api) плюс два тестовых проекта; зависимости направлены строго внутрь, у слоя Domain нет внешних зависимостей.
  • Мультитенантность: дискриминатор TenantId, закреплённый настоящим внешним ключом, global query filter в EF Core на каждой сущности, принадлежащей тенанту, и безусловная установка тенанта на сервере при каждой записи, так что вызывающая сторона не может подставить свой тенант. Во всей кодовой базе есть ровно одно допустимое исключение — поиск пользователя до входа — и оно задокументировано и проверяется, а не остаётся неявным.
  • Аутентификация: собственные JWT-токены (без внешнего identity-провайдера), claims из которых использует отдельный middleware для определения тенанта.
  • Данные и CQRS: PostgreSQL через EF Core, MediatR для обработки команд и запросов CQRS, пара Repository + UnitOfWork поверх одного общего scoped-контекста базы данных.
  • Векторный поиск: PostgreSQL с расширением pgvector, выбранный вместо нативного векторного типа SQL Server 2025 после прямого сравнения — индексация в pgvector стабильна и общедоступна, а приближённый поиск по индексу в SQL Server всё ещё в preview, и у его контейнера есть задокументированное падение под Docker на Apple Silicon. POST /api/search строит эмбеддинг запроса (Azure OpenAI или детерминированная офлайн-заглушка для локальной разработки) и выполняет запрос по косинусному расстоянию среди сохранённых эмбеддингов чанков — с ограничением по тенанту вручную в сыром SQL, потому что векторный запрос не сочетается с global filter в EF Core.
  • Загрузка документов: реальная отчётность SEC вместо чистого демо-текста. HTML и PDF читаются в типизированные DocumentElement (заголовок / абзац / таблица); текст разбивается на чанки по 250 токенов с перекрытием в 60 токенов (токенизатор cl100k), а каждая таблица остаётся одним неделимым чанком и делится по строкам, только если сама превышает бюджет. На годовом отчёте Apple 10-K за FY2025 (1,4 МБ HTML) это дало 296 чанков — 209 текстовых и 87 табличных — с p95 в 236 токенов, ни одного сверх бюджета, а весь пайплайн загрузки занял 0,75 с.
  • Тестирование: 137 тестов в модульных и интеграционных наборах, включая два независимых теста изоляции тенантов — один на уровне запросов к базе, другой с полным HTTP-циклом и реально выпущенными токенами, — а интеграционные тесты работают с настоящим контейнером PostgreSQL, а не с моком.

Путь запроса в Lumen с изоляцией тенантов: от входа до запроса документов, отфильтрованных по тенанту вызывающего

Сложности

Доказать изоляцию, а не предполагать её

мультитенантность через query filter легко реализовать с тонкой ошибкой; задача считается решённой, только когда её подтверждают тесты на двух разных уровнях и проверка по всей кодовой базе, что существует ровно одно задокументированное исключение.

Выбирать инфраструктуру по реальным эксплуатационным качествам

выбор векторной базы свёлся к реальным воспроизводимым ограничениям (падение контейнера на одной платформе, всё ещё preview-функция на другой), а не к общему спору «что лучше» — решение принято и записано до того, как от него начал зависеть код.

Работать с по-настоящему «грязными» документами

реальная отчётность — это реальные сбои: разбиение на чанки фиксированного размера резало финансовые таблицы посреди строки, отрывая числа от подписей. Обработка таблиц как неделимых чанков исправила это для 29% чанков, которые являются таблицами, а в журнале решений записано, когда к этому вернуться (если оценка поиска покажет, что вопросы по таблицам проваливаются).

Сохранить архитектурные решения за человеком при работе с AI-агентами

поручать агентам реализацию и ревью отдельных задач имеет смысл, только если само обоснование проектирования — почему такая граница изоляции, почему эта база, почему ровно одно исключение и никаких других — остаётся явным и не делегируется вместе с кодом.

Моя роль

Каждое проектное решение — стратегия изоляции тенантов, выбор базы данных, разбиение на слои — исследуется и записывается с обоснованием до начала реализации. Разработка идёт по spec-driven процессу, где AI-агенты под моим руководством выполняют реализацию и ревью на уровне отдельных задач, а каждый этап проверяется реальной сборкой и прогоном тестов, а не принимается на веру.

Результат

Lumen — действующий многоэтапный проект, а не готовый продукт: то, что уже построено, — фундамент, загрузка документов и эмбеддинги с векторным поиском в пределах тенанта — это первая половина более длинного плана, в котором ещё RAG-эндпоинт с настройкой на основе оценок, сам MCP-сервер и деплой. Выделяться здесь должно не то, сколько сделано, а то, как это делается: каждый этап начинается с настоящего исследования, каждое нетривиальное решение записано с обоснованием и измеренными цифрами, и ничего не выходит без независимой проверки — включая гарантию изоляции тенантов, подтверждённую двумя разными видами тестов, а не просто дизайном, который хорошо выглядит на бумаге.

Реальные продукты, практичная разработка и задачи, которые стоит решать.

Избранные работы: .NET, full-stack SaaS, AI-интеграции, инструменты для разработчиков, React, React Native и не только.

Связаться